¿Pueden los buscadores con IA citar menciones de marca en podcasts y vídeos de YouTube?
Los motores de búsqueda de IA pueden citar menciones de marca de podcasts y vídeos de YouTube, pero solo a través de transcripciones accesibles, páginas de episodio y cobertura de terceros. Así es …

Puntos clave
- Una cita mostrada suele enlazar a una URL de origen, como una página de reproducción, una página de episodio o una transcripción. El enlace por sí solo no revela si el sistema procesó texto, audio o vídeo
- Transcripción ≠ indexada ≠ recuperada ≠ citada. Cada una es una condición independiente con su propio modo de fallo, y cumplir una nunca garantiza la siguiente.
- Google afirma que las páginas de respaldo deben estar indexadas y ser aptas para aparecer en Search con un fragmento. Siguen aplicándose los requisitos técnicos y las políticas habituales de Search.
- Los resúmenes de terceros pueden citarse en lugar de la grabación original, porque ya son texto en una dirección rastreable, mientras que el propio episodio puede no llegar a serlo nunca.
- Cita ≠ mención ≠ recomendación. Una respuesta puede citar una fuente, nombrar una marca o aconsejar comprarla, y esos tres resultados tienen tres causas distintas.
- Un primer paso práctico es contar con una transcripción HTML pública y precisa, con etiquetas de interlocutor y marcas de tiempo útiles.
Respuesta rápida: ¿puede cada plataforma de IA citar una página de podcast o YouTube?
| Plataforma | ¿Puede citar una página de podcast/YouTube? | Condición documentada |
|---|---|---|
| ChatGPT (búsqueda) | Sí, con condiciones: la página, no el audio. | Las respuestas de búsqueda web pueden incluir citas, y una página de episodio pública o una transcripción pueden servir como fuente web; OpenAI señala que las citas pueden ser inexactas y que un panel de fuentes puede incluir enlaces no citados para ninguna afirmación. |
| Perplexity | Sí, con condiciones: el descubrimiento está documentado, el procesamiento de audio no. | PerplexityBot admite encontrar y enlazar sitios web en los resultados de búsqueda, y un caso de uso publicado localiza un vídeo relevante y, en contextos como su navegador, abre un segmento específico. |
| Gemini | Sí, con condiciones: en dos productos diferentes. | Gemini Apps puede encontrar vídeos y responder preguntas sobre ellos utilizando información pública de YouTube, sujeto a la configuración de la cuenta y de la actividad; la API de Gemini, por separado, analiza vídeos proporcionados, incluidas URL públicas de YouTube. |
| Google AI Overviews y AI Mode | Sí, con condiciones: la elegibilidad es un requisito previo, no una garantía de aparición. | Una página debe estar indexada y ser apta para aparecer en Google Search con un fragmento, sin requisitos técnicos adicionales. |
¿Qué es una mención de marca hablada?
Una mención de marca hablada es una referencia audible a una empresa, producto o servicio dentro de un discurso grabado, independientemente de si el nombre de la marca aparece en el título, la descripción o cualquier texto escrito que lo acompañe. En la búsqueda con IA, esa referencia se convierte en una posible fuente de citación solo cuando una representación accesible de la grabación (una transcripción, subtítulos sincronizados, contexto escrito o una entrada multimodal compatible) aporta evidencia relevante que un sistema de respuestas pueda recuperar y atribuir.
Términos clave: evento de mención, representación, recuperación y atribución
Cuatro componentes estructurales se sitúan entre una frase pronunciada ante un micrófono y un enlace bajo una respuesta generada por IA. Son partes de un ecosistema, no palancas.
| Término | Qué significa | Qué no resuelve |
|---|---|---|
| Evento de mención | La ocurrencia original: un presentador nombra un producto, un invitado compara dos proveedores, un reseñador lee un guion de patrocinador. | Si algún sistema llegó a detectarlo. El evento tiene valor de audiencia independiente de la búsqueda. |
| Representación del contenido | La forma en la que el evento queda disponible para otro sistema: subtítulos, transcripciones, títulos de capítulos, notas del episodio, resúmenes escritos, entradas de vídeo compatibles. | Cuánta evidencia sobrevivió. Una descripción que resume una entrevista no es el mismo artefacto que una transcripción de esta. |
| Capa de descubrimiento y recuperación | Los mecanismos que localizan y seleccionan información. La indexación organiza el contenido para búsquedas posteriores; la recuperación selecciona información para una solicitud concreta. | Que se haya usado la ruta normal de descubrimiento. Una fuente aportada por el usuario, o una obtenida en el momento de la solicitud por un agente activado por el usuario, puede entrar en una respuesta sin pasar por ella. |
| Atribución de respuesta | La relación entre una afirmación generada y la fuente mostrada junto a ella. | Si la respuesta nombra la marca, o la presenta como una opción adecuada. Son resultados distintos. |
Estas cuatro entidades aportan el vocabulario de trabajo para la optimización para motores de respuestas, también llamada optimización para motores generativos (GEO) o optimización para búsquedas con IA, pero su valor va más allá del marketing: separan lo que ocurrió en una grabación de lo que un sistema de búsqueda puede establecer sobre ello.
Conviene desmontar pronto una trampa terminológica, porque corrompe en silencio buena parte del análisis. El "caption" de una publicación en redes sociales es texto descriptivo escrito junto a la publicación. Los subtítulos cerrados (closed captions) son representaciones de texto sincronizadas del habla y otro audio. Una marca puede estar totalmente ausente del primero y presente en los segundos, que es exactamente una situación que explica muchas de las limitaciones de la monitorización.
Transcripción vs. indexación vs. recuperación vs. cita
| Etapa | Qué establece | Qué no establece |
|---|---|---|
| Transcripción | El habla se ha convertido en texto. | Que un sistema de búsqueda público llegue a encontrar, almacenar o usar ese texto. |
| Indexación | El contenido está disponible dentro de una colección rastreable. | Que la página indexada represente la conversación. Una página de episodio indexada puede contener solo un título, un reproductor y dos párrafos de descripción. |
| Recuperación | Se seleccionó información para una pregunta concreta. | Que se vaya a seleccionar para cualquier otra pregunta. Una transcripción puede permanecer en una colección durante meses sin ser recuperada, incluso para consultas sobre la marca nombrada en ella. |
| Cita | Se adjuntó una referencia de fuente a una afirmación generada. | Que la fuente citada respalde la afirmación, haya sido interpretada con precisión, o fuera la fuente original de la información. |
La investigación fundacional sobre generación aumentada por recuperación de Lewis y sus colegas, publicada en 2020, combinaba el conocimiento almacenado en los parámetros del modelo con pasajes obtenidos de una colección externa. Esa distinción, conocimiento aprendido frente a evidencia recuperada, es la razón por la que "la IA conoce mi marca" y "la IA citó la cobertura de mi marca" son afirmaciones diferentes con soluciones diferentes. De ahí no se deduce que todo asistente comercial implemente exactamente esa arquitectura.
Mención hablada vs. mención en texto
Una mención de texto pública en la web puede tener ya una URL y un contexto circundante que respalden el descubrimiento y la recuperación. Su accesibilidad e interpretación siguen dependiendo del sistema. La búsqueda puede identificar coincidencias por texto, por entidad o por similitud semántica.
Una mención hablada no tiene ninguna de esas propiedades en el momento en que ocurre. Todo lo que viene después depende de que se cree una representación, se publique en algún lugar accesible y se conserve con la precisión suficiente para coincidir con la forma en que un usuario formula una pregunta.
Para los equipos que solo han medido la cobertura escrita, esto replantea qué son las menciones de marca en términos operativos. Una mención hablada es real, tiene impacto de audiencia, y aun así puede ser invisible para todo sistema basado en texto de la cadena. Ambos hechos no están en conflicto.
¿Por qué una mención en un podcast no llega a convertirse en una cita de IA?
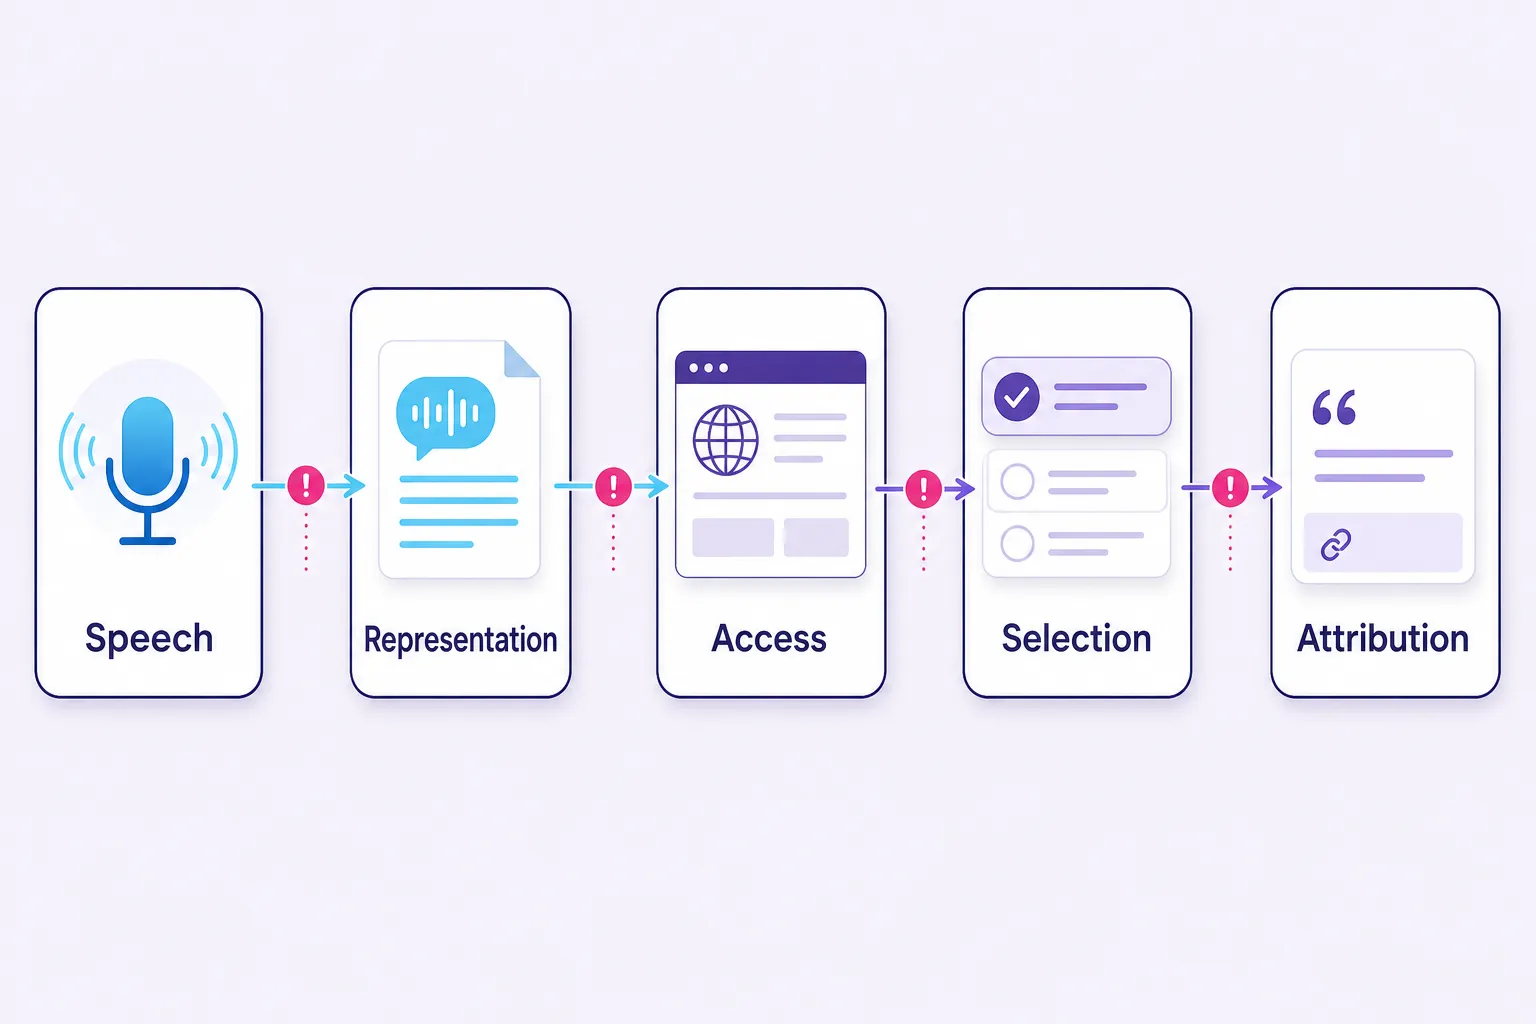
El Mapa de Evidencia de la Mención Hablada establece las dependencias entre una declaración grabada y una cita de IA que realmente pueda defenderse. Es un modelo de diagnóstico para determinar qué frontera no logró cruzar una mención, no una lista de tareas de optimización.
REFERENCIA DE MARCA HABLADA
        |
        v
REPRESENTACIÓN DISPONIBLE
transcripción, subtítulos, contexto escrito,
o análisis multimodal compatible
        |
        v
ACCESO A LA FUENTE
descubrimiento e indexación, o acceso compatible
en el momento de la solicitud por un sistema específico
        |
        v
SELECCIÓN ESPECÍFICA SEGÚN LA PREGUNTA
evidencia relevante recuperada e interpretada
        |
        v
ATRIBUCIÓN DE LA RESPUESTA
una declaración generada puede recibir un enlace a la fuente
Cuatro fronteras, cada una con su propio modo de fallo.
| Frontera | Pregunta de diagnóstico | Fallo típico |
|---|---|---|
| Representación | ¿Se conservaron las palabras en algún texto? | Solo existe una descripción vaga; el producto nombrado en el minuto 24 no sobrevive en ningún lugar. |
| Acceso | ¿Puede este sistema en particular acceder a esa representación? | La transcripción existe dentro de una app de escucha, no en una página pública rastreable. |
| Selección | ¿El pasaje responde a la pregunta que se está haciendo? | La historia de origen de un fundador no puede responder a una pregunta sobre el esfuerzo de migración. |
| Atribución | ¿Qué acredita realmente la respuesta, y a quién? | Se omite la salvedad, se acredita al interlocutor equivocado, o se cita una página diferente. |
Representación: ¿se conservaron las palabras?
Una grabación y su descripción no son evidencia intercambiable. Si un presentador nombra un producto en el minuto 24, una descripción que dice "una conversación sobre cómo escalar el soporte al cliente" no ha conservado nada sobre ese producto. Una transcripción podría hacerlo. Un resumen escrito también, con las palabras de otro editor y bajo la responsabilidad editorial de ese editor.
La unidad de análisis aquí es la declaración junto con su contexto, no la URL del episodio. Una URL de episodio indica dónde vive la conversación; no indica qué frases sobrevivieron en forma de texto.
Acceso: ¿puede este sistema en particular llegar a ella?
Una transcripción visible dentro de una app de escucha no está automáticamente disponible a través de una página web pública, y una página web pública no es automáticamente accesible para todos los rastreadores o sistemas que la solicitan bajo demanda.
El acceso también es específico de cada fuente y de cada sistema. Un asistente puede acceder a un artículo que cita una entrevista sin llegar nunca a la grabación. Eso produce una vía de evidencia indirecta, lo cual es un resultado legítimo, pero no es evidencia de procesamiento de audio.
Selección: ¿el pasaje responde a esta pregunta?
Una referencia de marca accesible no se vuelve útil para cualquier pregunta sobre la marca. La historia de origen de un fundador respalda una pregunta sobre la historia de la empresa y puede no decir nada relevante a un comprador que pregunta sobre el esfuerzo de migración o las limitaciones del soporte.
Relevancia aquí significa que la declaración ayuda a responder la pregunta real formulada. No significa que el nombre de la marca aparezca con frecuencia. La guía publicada por Google sobre sus sistemas de clasificación describe la clasificación por pasajes, que identifica secciones individuales de una página para evaluar su relevancia, por lo que la afirmación común de que una mención breve dentro de una transcripción larga siempre queda diluida hasta volverse inútil exagera el caso. Lo que sigue siendo cierto es que un comentario breve compite contra documentos escritos específicamente para responder la pregunta.
Atribución: ¿qué acredita realmente la respuesta?
Un sistema puede citar la transcripción de un episodio mientras nombra la empresa del invitado. Puede citar el episodio sin nombrar esa empresa en absoluto. Puede nombrar la empresa mientras cita una página completamente distinta. Mantener esos resultados separados es lo que hace que el análisis de menciones de marca e IA sea útil en lugar de anecdótico.
El punto central del mapa es fácil de enunciar y fácil de olvidar: la evidencia puede fallar al cruzar una frontera incluso después de haber cruzado con éxito la anterior. La detección no establece el acceso. El acceso no establece la selección. La selección no establece una atribución precisa.
Dónde reside la evidencia: una comparación formato por formato
La posibilidad de ser descubierto depende de qué representación contiene la mención y de si esa representación es accesible. La comparación siguiente describe la disponibilidad de evidencia y las rutas plausibles. No es una probabilidad de citación medida ni un orden de clasificación.
| Formato de contenido | Evidencia que puede contener | Posible ruta hacia una respuesta de IA | Lo que su existencia no demuestra |
|---|---|---|---|
| Archivo de audio o vídeo original | El habla original, el tono y toda la conversación circundante | Análisis de medios compatible, o un proceso de transcripción independiente | Que algún producto de búsqueda procese automáticamente la grabación |
| Subtítulos nativos de la plataforma o transcripción automática | Palabras habladas, a menudo con información de tiempo, sujetas a errores de reconocimiento | Integración con la plataforma, o recuperación cuando el texto está expuesto | Que toda pista de subtítulos esté indexada, o disponible para todo asistente |
| Transcripción HTML pública en la página del episodio | Diálogo rastreable, etiquetas de hablante, notas contextuales | Descubrimiento, indexación y recuperación ordinarios de páginas web | Que la página esté indexada, seleccionada para una consulta, o citada |
| Descripción del episodio, notas del programa o texto del feed | Resúmenes, invitados mencionados, productos mencionados, enlaces | Recuperación de la página o de la información disponible en el feed | Que una referencia hablada no listada esté representada en algún lugar |
| Transcripción del podcast dentro de la app | Texto del episodio dentro de una única experiencia de escucha | Acceso proporcionado por ese producto o sus integraciones | Que los rastreadores externos reciban el mismo texto |
| Artículo, resumen o newsletter de terceros | El relato de otro editor sobre la conversación | Recuperación y citación de la página de ese editor | Que se haya accedido a la grabación, o que esté representada con precisión |
| Hilo de la comunidad que comenta el episodio | Interpretación de los oyentes, citas, correcciones, desacuerdo | Recuperación de la página de la plataforma, sujeta a sus normas | Que el pasaje citado sea exacto o completo |
Esta estructura es coherente con la guía sobre transcripciones de la Web Accessibility Initiative del W3C, que trata las transcripciones como alternativas textuales al audio, distingue entre transcripciones básicas y descriptivas, y señala que las transcripciones web suelen usar HTML con hablantes identificados. La práctica de accesibilidad y la práctica de visibilidad apuntan aquí en la misma dirección por razones distintas, lo cual es una de las pocas alineaciones realmente seguras en este campo.
Las filas inferiores también explican un patrón que vale la pena interiorizar: la cobertura de terceros sobre un episodio a menudo se convierte en el artefacto citable, mientras que el episodio en sí no. El artículo ya es texto, ya es temático, ya tiene una dirección rastreable. Esto forma parte de la explicación más amplia de por qué la IA cita fuentes como los foros comunitarios con tanta facilidad, y significa que el origen de una información y el destino de la citación visible a menudo difieren.
¿Cómo gestionan ChatGPT, Perplexity, Gemini y Google AI Overviews las fuentes de vídeo y podcast?
Cada plataforma puede mostrar fuentes relacionadas con vídeos o podcasts, pero su documentación oficial describe mecanismos distintos, y ninguna documenta un proceso universal que "escuche" grabaciones públicas arbitrarias en respuesta a una consulta de búsqueda. La comparación solo funciona si se separan las aplicaciones para el consumidor, las funciones de búsqueda y las API para desarrolladores.
| Plataforma | Mecanismo documentado | Lo que NO establece | Fuente oficial |
|---|---|---|---|
| ChatGPT (búsqueda) | Las respuestas de búsqueda web pueden incluir citas; un panel de Fuentes puede contener tanto fuentes citadas como otros enlaces relevantes; las citas pueden ser inexactas. Una transcripción pública o una página de episodio pueden servir como fuente web. OAI-SearchBot y GPTBot tienen controles de robots.txt independientes para la búsqueda y un posible uso en entrenamiento. ChatGPT-User gestiona ciertas visitas iniciadas por el usuario, para las cuales el robots.txt puede no aplicarse. | Acceso nativo a las pistas de subtítulos de YouTube, o procesamiento automático del audio de un podcast. Un enlace en un panel de Fuentes tampoco establece una atribución a nivel de afirmación. | Ayuda de ChatGPT Search · Documentación de rastreadores de OpenAI |
| Perplexity | Un caso de uso publicado de descubrimiento de vídeo en el que el producto localiza un vídeo relevante y, en contextos como su navegador, abre un segmento específico. PerplexityBot admite encontrar y enlazar sitios web en los resultados de búsqueda; Perplexity-User visita una página en respuesta a una solicitud del usuario; ambos se distinguen del entrenamiento de modelos fundacionales. | Que cada referencia hablada en YouTube esté indexada de forma continua, o que las transcripciones tengan el mismo peso que las páginas web editoriales. | Documentación de rastreadores de Perplexity |
| Gemini Apps frente a Gemini API | Gemini Apps puede encontrar vídeos y responder preguntas sobre ellos usando información pública disponible de YouTube, sujeto a la configuración de la cuenta y de la actividad, y la función no está presente en todas las superficies de Gemini. La API es una vía distinta: un desarrollador envía una entrada de vídeo compatible (incluidas URLs públicas de YouTube) para su análisis en información de audio y visual con referencias de marca temporal, y la comprensión agentiva de vídeo permite que el modelo elija qué segmentos y qué señales inspeccionar. | Que una consulta espontánea de un posible comprador recupere una mención de marca concreta. Una buena respuesta de vídeo de Gemini no predice una cita en Google AI Overviews. | Ayuda de Gemini Apps sobre YouTube · Comprensión de vídeo de la API de Gemini |
| Google AI Overviews y AI Mode | Para aparecer como enlace de apoyo, una página debe estar indexada y ser apta para aparecer en Google Search con un fragmento, sin requisitos técnicos adicionales. El query fan-out distribuye búsquedas relacionadas entre subtemas, y AI Mode y AI Overviews pueden usar modelos y técnicas diferentes, por lo que las respuestas y los enlaces pueden variar. Entre las bases recomendadas está disponer del contenido importante en formato textual; no se prescribe ningún marcado especial para IA. | La inclusión. La elegibilidad es una condición previa, no una garantía de posicionamiento. Tampoco establece que una frase hablada en una plataforma de vídeo esté indexada. | Google Search Central: funciones de IA |
¿Google AI Overviews cita vídeos de YouTube? Lo que Google documenta realmente
Sí, con condiciones, y aquí la regla es explícita, no inferida. Para AI Overviews y AI Mode, la condición documentada es que la página esté indexada y sea elegible para aparecer con un fragmento. Por eso una página de episodio con noindex no puede ser un enlace de respaldo, y por eso una directiva nosnippet puede limitar cómo se usa una página aunque siga indexada. Una página de reproducción de YouTube citada en un AI Overview te indica que se mostró una URL; no te indica si la evidencia la aportaron los subtítulos, la descripción, una integración de la plataforma o una página de terceros.
Si la afirmación de un competidor sobre una plataforma de IA no se puede rastrear hasta la documentación propia de esa plataforma o hasta un estudio fechado con un método indicado, trátala como una hipótesis y diseña una comprobación, no como una regla para optimizar.
¿Qué motores de búsqueda de IA citan más a YouTube? Lo que muestran los estudios de share de citas
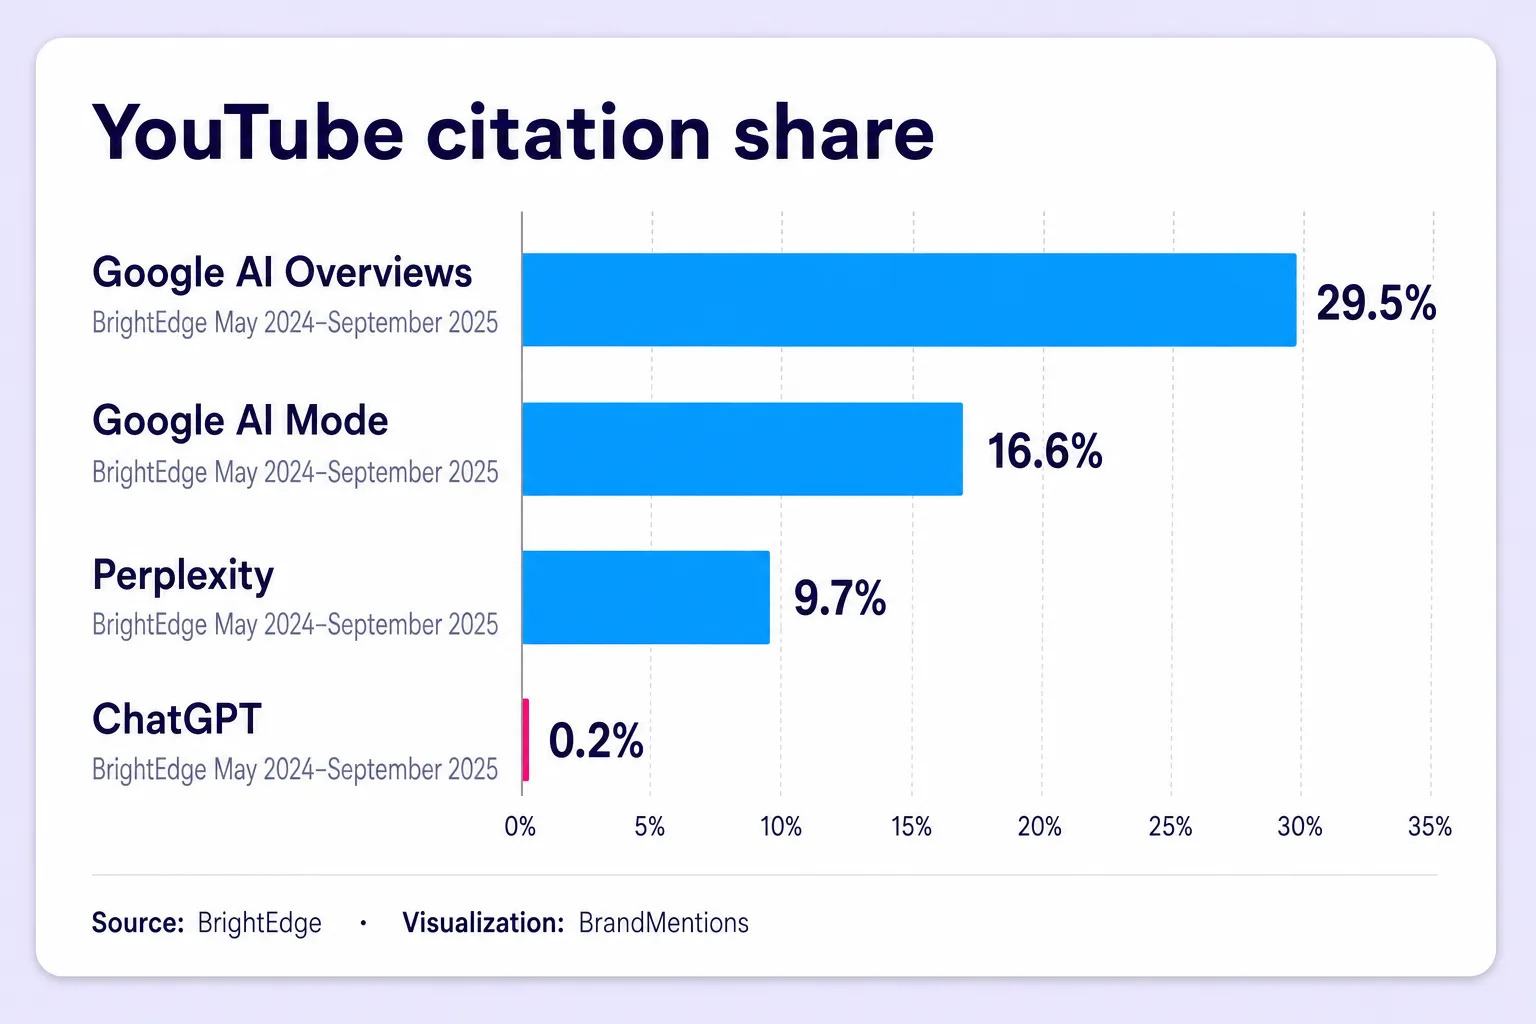
BrightEdge reportó cifras de citas de YouTube más altas para las superficies de IA de Google que para Perplexity y ChatGPT. Otros conjuntos de datos reportan patrones distintos, por lo que este orden no debería tratarse como universal. Los conjuntos de datos independientes que muestran con qué frecuencia aparecen diversos dominios como citas son genuinamente útiles para orientarse. Los estudios reportan patrones y magnitudes distintos según la plataforma. Sus resultados deben interpretarse dentro del conjunto de consultas, el periodo de recopilación y la definición de share de citas de cada estudio.
| Plataforma | Métrica de citas de YouTube reportada | Estudio y periodo |
|---|---|---|
| Google AI Overviews | 29,5% de share de citas, dominio #1 | BrightEdge, mayo de 2024 - septiembre de 2025 |
| Google AI Mode | 16,6% de share, dominio #1 | BrightEdge, mayo de 2024 - septiembre de 2025 |
| Perplexity | 9,7% de share, dominio #5 | BrightEdge, mayo de 2024 - septiembre de 2025 |
| ChatGPT | 0,2% de share | BrightEdge, mayo de 2024 - septiembre de 2025 |
BrightEdge describe estas cifras como "share de citas" y también describe la cifra de AI Overviews como el porcentaje de overviews que citan a YouTube. Su resumen público no establece con claridad un denominador consistente para cada cifra.
Los periodos de recopilación y los conjuntos de consultas importan tanto como las cifras. BrightEdge analizó los patrones de citas de YouTube en Google AI Overviews, Google AI Mode, ChatGPT y Perplexity desde mayo de 2024 hasta septiembre de 2025 usando su plataforma AI Catalyst, siguiendo tasas de citas, competencia entre plataformas, tipos de consulta y cambios semana a semana, y reportó que YouTube se cita 200 veces más que cualquier otra plataforma de video en los resultados de búsqueda con IA, con Vimeo, su rival más cercano, en 0,1%. La comparación de plataformas de Profound, medida sobre su propio conjunto de prompts, separa el total de citas del share entre las fuentes principales y reporta que YouTube representa el 1,9% del total de citas de Google AI Overviews pero el 18,8% de su share entre las 10 fuentes principales, frente a un 2,0% del total de citas de Perplexity y un 13,9% de su share entre las top 10. El estudio más amplio de Peec AI, que abarca 30 millones de fuentes en ChatGPT, Google AI Mode, Gemini, Perplexity y AI Overviews y mide los dominios citados directamente en las respuestas, sitúa a Reddit en primer lugar en general entre los cinco motores. Su desglose por plataforma sitúa a YouTube en primer lugar en AI Mode y AI Overviews, a Reddit en primer lugar en Gemini y Perplexity, y a Wikipedia en primer lugar en ChatGPT. El estudio de fuentes de Agenzy de 2026 reporta shares absolutos más bajos en la misma dirección: YouTube obtuvo el 4,7% de las citas de Google AI Overviews y el 0,03% de las citas de ChatGPT entre 2.283.923 citas de IA (137 proyectos empresariales para la cifra de Google AI Overviews y 138 para la cifra de ChatGPT).
Esos cuatro conjuntos de datos usan paneles, conjuntos de prompts, periodos y definiciones de "share" distintos, por lo que sus cifras no son intercambiables. Ni los porcentajes ni el orden entre plataformas deberían generalizarse más allá de los conjuntos de datos que los produjeron.
Qué puede y qué no puede demostrar la investigación sobre share de citas
Una cita hacia un dominio de video establece un destino. No revela si el sistema utilizó subtítulos, descripciones, una integración de plataforma, una página de terceros u otra representación. Los recuentos de dominios no pueden descifrar a la inversa un mecanismo de procesamiento. Los shares publicados también son instantáneas ligadas a un periodo de recopilación, un conjunto de consultas y una versión de producto, y los conjuntos de datos de los proveedores a veces no coinciden ni con sus propios gráficos.
La evidencia correlacional más relevante proviene del estudio de Ahrefs sobre correlaciones de visibilidad en IA de marca, publicado en diciembre de 2025 sobre aproximadamente 75.000 marcas, que encontró que las menciones en YouTube se encuentran entre los correlatos más fuertes de la visibilidad en IA de marca en los sistemas examinados. Dos advertencias pesan tanto como el hallazgo. El estudio definió una mención en YouTube como un nombre de marca que aparece en el título, la transcripción o la descripción de un video, por lo que es una medida compuesta que no aísla las referencias habladas. Y la correlación no establece causalidad: las marcas de las que se habla en video suelen ser marcas de las que se habla en todas partes.
Un pequeño estudio original: qué cambió al añadir una transcripción de podcast
En una prueba de antes y después con un solo episodio, la página del episodio no recibió ninguna cita en 24 respuestas de referencia a preguntas sobre el producto y la categoría, y recibió cinco citas en 24 respuestas tras publicar una transcripción en HTML. La publicación de la transcripción se asoció con un cambio en las citas observadas. La prueba no establece causalidad ni predice con qué frecuencia se citarán otros episodios.
Qué probé
Probé la página de un episodio de podcast ya existente antes y después de añadir una transcripción en HTML con etiquetas de interlocutor y marcas de tiempo. La URL se mantuvo igual.
El episodio presentaba a un invitado que hablaba de un producto de atención al cliente. Ni el nombre de la marca ni la afirmación sobre el tiempo de aprobación analizada en este estudio aparecían en el título original de la página, en la descripción ni en las notas del programa. Antes de la edición, la página contenía un reproductor y aproximadamente 180 palabras que presentaban al invitado y el tema.
En la grabación, el invitado explicó que había reducido el tiempo de aprobación de dos días a cuatro horas tras cambiar al producto. Al añadir la transcripción, esa afirmación quedó disponible como texto HTML en la página del episodio.
La página ya estaba indexada antes de la prueba. Las pruebas de seguimiento se realizaron un día después de que Google Search Console mostrara que la página actualizada había sido rastreada de nuevo. Esto no determinó si Google había procesado la transcripción, ni si ChatGPT o Perplexity podían recuperarla.
Se utilizaron cinco prompts fijos para probar las citas a la página del episodio: cuatro sobre el producto y su categoría, y uno sobre información ya disponible en las notas del programa.
| ID | Prompt |
|---|---|
| T1 | «¿Para qué tamaño de equipo de soporte es adecuado Brand Name?» |
| T2 | «¿Qué rapidez tiene el flujo de aprobación de Brand Name?» |
| T3 | «¿Qué herramientas de enrutamiento de help desk funcionan para un equipo de tres personas?» |
| T4 | «¿Cómo se compara Brand Name con otras herramientas de atención al cliente?» |
| T5 | "¿Quién fue el invitado en el episodio de The Podcast Show sobre escalado?" |
"Brand Name" sustituye al nombre real del producto, y "The Podcast Show" sustituye al título real del podcast. Las pruebas originales usaron ambos nombres reales. T5 pedía información ya disponible en las notas del programa.
Las cuatro preguntas sobre el producto y la categoría no dependían por igual de la transcripción. T2 trataba directamente sobre el tiempo de aprobación reportado por el invitado. T1 y T4 requerían evidencia más amplia sobre idoneidad y comparaciones. T3 no nombraba la marca y probaba si el episodio aparecería para una pregunta a nivel de categoría. Otras fuentes web podrían haber respondido también a estas preguntas.
Cada uno de los cinco prompts se ejecutó tres veces en ChatGPT con búsqueda activada y tres veces en Perplexity, en ambas rondas: 30 respuestas por ronda y 60 en total. Detalles de la prueba: referencia el 2026-10-02; publicación de la transcripción el 2026-10-06; seguimiento el 2026-10-10. Las pruebas usaron inglés (configuración regional de EE. UU.), el modo de búsqueda de ChatGPT y Perplexity (versiones de modelo según se mostraban en el momento de la ejecución, cuando estaban disponibles), y conversaciones nuevas en cada ejecución.
Anonimización y verificación. La URL del episodio y la identidad de la marca se omiten por privacidad. Los cinco prompts anteriores conservan su redacción original, salvo la anonimización del nombre del producto y del título del podcast. Omitir la fuente limita la verificación independiente de la página, la transcripción y las evaluaciones de respaldo de las citas. Estos hallazgos son una observación exploratoria anonimizada, no un benchmark reproducible de forma independiente.
Qué citaron las respuestas
En T1–T4, las citas a la página del episodio cambiaron de la siguiente manera:
| Plataforma | Antes de publicar la transcripción | Después de publicar la transcripción |
|---|---|---|
| ChatGPT con búsqueda | 0 de 12 respuestas | 4 de 12 respuestas |
| Perplexity | 0 de 12 respuestas | 1 de 12 respuestas |
| Total | 0 de 24 respuestas | 5 de 24 respuestas |
Las citas de seguimiento se distribuyeron de forma desigual:
| Prompt | ChatGPT | Perplexity |
|---|---|---|
| T1: Idoneidad del equipo | 1 de 3 respuestas | 0 de 3 respuestas |
| T2: Tiempo de aprobación | 2 de 3 respuestas | 1 de 3 respuestas |
| T3: Categoría y caso de uso | 0 de 3 respuestas | 0 de 3 respuestas |
| T4: Comparación de productos | 1 de 3 respuestas | 0 de 3 respuestas |
La pregunta sobre el tiempo de aprobación generó tres de las cinco citas. También era la pregunta más directamente relacionada con el resultado reportado por el invitado.
En el quinto prompt, que pedía la identidad del invitado, las citas aumentaron de cinco de seis respuestas de referencia a seis de seis respuestas de seguimiento. Por tanto, la página ya aparecía como fuente para información disponible en sus notas del programa antes de añadir la transcripción. Esta pregunta de referencia aporta contexto, pero no permite descartar cambios en el comportamiento de la plataforma entre rondas.
Ninguna de las dos plataformas citó el episodio en T3. Esa ausencia no determina si la página era inaccesible, si nunca se recuperó, o si se consideró menos útil que otras fuentes. Solo demuestra que la página no recibió ninguna cita en esas seis respuestas de seguimiento.
¿Las citas respaldaban las respuestas?
Revisé las cinco citas de seguimiento para evaluar si el episodio respaldaba las afirmaciones asociadas a ellas.
Dos se consideraron claramente respaldadas en la revisión inicial. Una reprodujo con precisión el cambio reportado de dos días a cuatro horas. Otra respaldaba una afirmación de comparación, aunque su enlace apuntaba a la página del episodio en lugar de a un pasaje concreto.
Las tres restantes plantearon problemas diferentes:
- Una parafraseó el resultado como «redujo el tiempo de aprobación a horas», omitiendo el punto de partida de dos días.
- Otra infirió una idoneidad de equipo que la transcripción no establecía explícitamente.
- Otra citó el episodio sin dejar claro el pasaje de apoyo.
Estas cuestiones no deben tratarse como tres errores fácticos equivalentes. Omitir la referencia inicial puede reducir la exhaustividad sin que la afirmación sea falsa. Una cita a nivel de episodio también puede respaldar una afirmación sin enlazar a una marca de tiempo concreta. En cambio, usar una experiencia individual para inferir la idoneidad general de un equipo puede ir más allá de la evidencia disponible.
Por tanto, la auditoría no justifica una puntuación simple de «dos correctas, tres incorrectas». Ilustra por qué la presencia de la cita, el respaldo de la afirmación y la facilidad de verificación requieren evaluaciones independientes.
Qué respalda este estudio y qué no
El hallazgo concreto es que la publicación de una transcripción en HTML fue seguida de cinco citas a la página del episodio en 24 respuestas sobre el producto y la categoría, frente a ninguna en las 24 respuestas de referencia. ChatGPT generó cuatro de esas citas de seguimiento y Perplexity generó una.
Son frecuencias observadas dentro de esta prueba. Tres repeticiones por prompt y plataforma son insuficientes para establecer probabilidades estables de cita o una clasificación general de plataformas. Las 24 respuestas de cada ronda también representan observaciones repetidas en torno a cuatro preguntas sobre un mismo episodio, y no 24 ejemplos de fuentes independientes.
El diseño no aísla el efecto causal de la transcripción. Transcurrió tiempo entre rondas, el estado de indexación pudo haber cambiado, y el comportamiento de las plataformas pudo haber cambiado. La pregunta sobre la identidad del invitado ofrece un punto de referencia, pero no es una página de comparación sin tratar.
La anonimización limita aún más lo que los lectores pueden verificar de forma independiente. Un seguimiento más sólido incluiría varios episodios, páginas comparables sin modificar, pruebas repetidas en varias fechas y un segundo revisor que aplicara criterios predefinidos para evaluar el respaldo de las citas.
Para el mapa de evidencia de este artículo, el estudio ilustra una distinción limitada pero útil: publicar una transcripción cambia la evidencia disponible en una página; observar una cita muestra una atribución visible. Ninguna de las dos observaciones por sí sola revela el proceso completo de recuperación ni demuestra que cada afirmación citada esté respaldada.
Cómo hacer que una mención de marca hablada sea citable por la búsqueda de IA
No existe forma de garantizar una cita, y quien promete una está vendiendo una esperanza. Lo que sí puedes hacer es eliminar cada obstáculo documentado entre una frase hablada y un motor de respuestas, en el orden que sugiere el mapa de evidencias. Cada paso que sigue es una tarea de eliminación de obstáculos, no un truco de posicionamiento, y cada uno termina con el resultado que debería producir.
- Publica una transcripción HTML precisa en la página del episodio. Coloca el diálogo completo en HTML en la misma página que el reproductor, con etiquetas de interlocutor y marcas de tiempo. Una transcripción en HTML puede favorecer la accesibilidad a la vez que convierte el diálogo en texto web disponible. Una transcripción que solo existe en el panel de un creador, un archivo de feed o una app de escucha es una situación de acceso distinta, aunque las palabras sean idénticas.
Resultado: la mención hablada ahora existe como texto rastreable en la misma dirección que la grabación. - Nombra la marca, el producto y la categoría en la capa escrita. Las notas del programa, los títulos de los capítulos y las descripciones del episodio establecen el tema que una transcripción desnuda puede dejar enterrado. Escribe la categoría y el caso de uso, no solo el nombre de la marca: «enrutamiento de help desk para un equipo de soporte de tres agentes» aporta muchísima más evidencia recuperable que un nombre de producto aislado. Nunca escribas en las notas del programa una afirmación que la grabación no contenga realmente.
Resultado: la página expresa el tema y el caso de uso que un comprador realmente buscaría. - Confirma que la página está indexada y es apta para fragmentos. La condición documentada de Google para aparecer como enlace de respaldo en AI Overviews o en el Modo IA es que la página esté indexada y sea apta para aparecer en Google Search con un fragmento (snippet). Comprueba el estado de indexación antes de debatir cualquier cosa más exótica; la elegibilidad es una condición previa, no una posición garantizada.
Resultado: la página del episodio cumple la condición de elegibilidad declarada por Google para enlaces de respaldo, sujeta a los requisitos habituales de Search. - Audita cada control de acceso por separado, no como un único interruptor. El bloqueo de rastreo, la exclusión del índice, los límites de fragmentos, Google-Extended y los tres user agents independientes de OpenAI hacen cosas distintas en lugares distintos; los efectos de cada control se detallan en Bloqueado, excluido, restringido y retenido. Registra el estado actual de cada directiva, por propiedad, en lugar de asumir que un solo ajuste rige todas las superficies de IA.
Resultado: sabes exactamente qué sistemas pueden obtener, indexar y citar la página, directiva por directiva. - Verifica la transcripción contra la grabación antes de confiar en ella. Revisa con cuidado los nombres de marca: los subtítulos automáticos pueden reconocer mal nombres propios, términos poco comunes y homófonos. Comprueba que tu nombre esté escrito correctamente en todo el texto, que los interlocutores estén atribuidos correctamente, que las matizaciones se hayan mantenido y -en el caso de los podcasts- que el audio insertado dinámicamente no haya hecho que la transcripción mostrada diverja de lo que escucharon los oyentes.
Resultado: el texto que un motor puede recuperar coincide con lo que realmente escucharon los oyentes. - Para apariciones en medios de terceros, pide al editor que publique o mejore su propia transcripción. La accesibilidad técnica no es autorización. La transcripción de un editor es contenido suyo: enlázala, cítala dentro de los límites que permitan el editor y la ley, y no la vuelvas a publicar ni la edites en tu propio dominio sin acuerdo previo - convertir el audio de otra persona en un activo escrito propio sin permiso es una cuestión legal disfrazada de cuestión técnica. Pedir una transcripción, mejores notas del programa o un capítulo con marca de tiempo es la vía legítima y, por lo general, la más rápida.
Resultado: existe una transcripción citable en el dominio del editor, con el permiso intacto. - Trata la cobertura derivada como distribución, no como corroboración, y dirige las correcciones al derivado más citado. Una misma entrevista puede existir como episodio, tres clips, una transcripción, un extracto de newsletter y cinco resúmenes, todos con un único origen, de modo que contar cada derivado como una validación independiente exagera lo que esa aparición realmente demostró. Cuando una afirmación hablada necesita corrección, da prioridad a la página con más probabilidades de ser citada en lugar de limitarte a la grabación original; el problema de propagación se detalla en qué ocurre cuando se corrige una afirmación hablada.
Resultado: las correcciones llegan al artefacto que un motor tiene más probabilidades de recuperar, y la aparición se contabiliza una sola vez. - Registra las observaciones de citas de forma longitudinal, con un registro de observación completo. En cada comprobación, registra el prompt, la plataforma y el modo, la versión del modelo si está visible, la fecha y la hora, la configuración regional, si se ejecutó una búsqueda, la lista completa de fuentes mostradas, una captura de pantalla o transcripción guardada, y el número de repeticiones que respaldan la conclusión. Una sola captura de pantalla es una impresión; una serie fechada sobre un conjunto fijo de consultas es evidencia.
Los pasos 1 a 4 cambian lo que es posible. Los pasos 5 a 8 cambian lo que puedes defender. La mayoría de los equipos hace la primera mitad e informa como si hubiera hecho la segunda.
¿Por qué puede la IA de búsqueda pasar por alto una mención de marca dentro de un vídeo?
La IA de búsqueda pasa por alto referencias habladas porque las palabras no están disponibles, están representadas de forma inexacta, son inaccesibles para ese sistema en concreto, no son suficientemente claras o son irrelevantes para la pregunta formulada. Son cinco problemas distintos, y reducirlos todos a "el algoritmo nos ignora" los hace imposibles de diagnosticar.
| Modo de fallo | Síntoma | Qué lo soluciona realmente |
|---|---|---|
| Texto ausente | No hay transcripción, ni subtítulos, ni contexto escrito | Crear una representación (paso 1 anterior) |
| Texto inaccesible | La transcripción existe, pero no está donde el sistema pueda acceder a ella | Publicarla en una página pública indexable; auditar los controles de acceso (pasos 3-4) |
| Texto no seleccionado | La transcripción accesible nunca se elige para la consulta | Añadir el contexto que hace que el pasaje responda a una pregunta real (paso 2) |
| Referencia poco clara | Se nombra la marca, pero no se dice nada atribuible | No es algo técnico; las propias palabras eran insuficientes |
| Irrelevante para la consulta | La fuente está bien; la pregunta es distinta | Se necesita otra cobertura, no un mejor formato |
La ausencia de una transcripción tampoco demuestra que toda ruta multimodal sea imposible; establece el hecho más limitado de que falta una representación textual específica.
Bloqueado, excluido, restringido y retenido son cuatro estados diferentes
Esta es la distinción que la mayoría de los artículos sobre el tema simplifican en exceso, y es importante porque los controles se sitúan en lugares distintos y tienen efectos distintos.
| Control | Qué hace | Efecto en el uso de funciones de IA |
|---|---|---|
| robots.txt disallow | Indica a los rastreadores que cumplen las normas que no obtengan las URL especificadas | Restringe el rastreo de los rastreadores que cumplen las normas; los sistemas de obtención iniciados por el usuario pueden seguir reglas distintas |
noindex | Indica a los motores de búsqueda compatibles que no indexen la página | Elimina la posibilidad de usarse como enlace de apoyo en las funciones de IA de Google |
nosnippet / max-snippet / data-nosnippet | Limita el texto que se puede mostrar | Puede restringir cómo se usa una página en las funciones de IA sin dejar de estar indexada |
| Google-Extended | Rige ciertos usos de Gemini Apps y de respuestas fundamentadas (grounded) | Es independiente de la elegibilidad habitual de Google Search |
| OAI-SearchBot / GPTBot / ChatGPT-User | Controles separados de rastreo para búsqueda y entrenamiento; ChatGPT-User gestiona ciertas visitas iniciadas por el usuario, para las que robots.txt puede no aplicarse | Un sitio ausente de los resultados de búsqueda aún puede aparecer como enlace de navegación |
Una red de pódcast que bloquea uno de estos controles sin entender los demás suele producir un resultado que nadie pretendía. Si un editor quiere que las páginas de episodios se puedan usar como fuentes, la auditoría debe hacerse control por control, no como un único interruptor de encendido/apagado.
Error de transcripción frente a entidad ambigua frente a alias en otro idioma
Los subtítulos automáticos pueden reconocer mal nombres de marca, términos poco comunes y homófonos. Verifica las referencias importantes a productos comparándolas con la grabación. Si una transcripción automática convierte la marca ficticia "LumaDesk" en "luna de escritorio", una búsqueda de coincidencia exacta con el nombre correcto no la encontrará.
De ahí no se deduce que la cita sea imposible. La recuperación moderna incluye coincidencia semántica, y un sistema puede resolver una referencia a partir del contexto circundante. Esa recuperación debe considerarse posible, no darse por hecha, y nunca debe usarse como estrategia.
La ambigüedad es un problema distinto que persiste incluso con una transcripción perfecta. "Notion", "Monday" y "Apple" pueden referirse a marcas o a palabras comunes, y un término aislado aporta menos evidencia que un pasaje que nombra el producto, la categoría y la acción.
Las condiciones multilingües añaden una tercera capa que casi ninguna guía publicada aborda. Una marca pronunciada en un idioma puede transcribirse con una ortografía local, transliterarse de forma incoherente o representarse de otra manera distinta en subtítulos traducidos automáticamente. El cambio de idioma dentro de una misma frase es habitual en muchos mercados. Que una consulta en un idioma recupere una mención representada en otro depende de la gestión interlingüística del sistema de recuperación, algo que ninguna plataforma importante documenta al nivel de resolución de entidades de marca. Para cualquier marca con un nombre en un alfabeto no latino o con varias transliteraciones aceptadas, esto no es un caso excepcional.
Una referencia sin una afirmación atribuible
Compara estas tres frases hipotéticas. "Consideramos varios productos, entre ellos LumaDesk" establece una consideración. "Elegimos LumaDesk porque admitía nuestro flujo de aprobación" establece una selección declarada y un motivo. "Todo el mundo dice que LumaDesk es bueno" reporta una opinión sin especificar.
Las tres contienen el nombre de la marca. Cada una respalda una respuesta distinta y acotada: una consideración, un motivo de selección declarado o una opinión reportada sin especificar. Ninguna por sí sola establece la idoneidad general del producto. La identidad de quien habla agrava esto: la experiencia de un invitado, el respaldo de un presentador, la queja citada de un cliente y una lectura patrocinada nunca deben tratarse como el mismo tipo de evidencia.
Desajuste de versión entre lo que se escuchó y lo que se escribió
Apple documenta que el audio insertado dinámicamente que cambia después de la transcripción original puede no aparecer en la transcripción mostrada. Para una marca mencionada dentro de un segmento insertado, la experiencia del oyente y el texto recuperable divergen de verdad.
Por eso, la URL del episodio no siempre es un identificador de evidencia completo. La versión de la grabación, la versión de la transcripción y la fecha de la observación pueden importar cuando se disputa una afirmación.
Representaciones adversarias e inexactas
Como la recuperación opera sobre representaciones y no sobre la grabación, la propia representación es una superficie de integridad. Los archivos de subtítulos cargados pueden diferir de lo que realmente se dijo. Las transcripciones pueden editarse después de la publicación. Los resúmenes generados automáticamente pueden atribuir la declaración de un invitado a un presentador. El audio sintético puede fabricar un respaldo que nunca ocurrió, y el texto recuperado de una página puede contener instrucciones dirigidas al sistema que lo lee en lugar de información para el lector.
Nada de esto es motivo de alarma, y nada de esto está documentado como un ataque común dirigido específicamente a las menciones de marca. Es, eso sí, un motivo para verificar una transcripción contra la grabación antes de tratarla como evidencia, en particular cuando el pasaje citado es favorable, inesperado o lo bastante perjudicial como para actuar en consecuencia.
Cuando una transcripción y una grabación no coinciden, revisa la grabación original y su procedencia para establecer qué se dijo. Verifica por separado si la afirmación en sí es cierta.
Para los equipos que realizan un diagnóstico más amplio de una marca ausente en la búsqueda con IA, las menciones habladas merecen una línea aparte precisamente porque fallan de formas que la cobertura escrita nunca presenta.
¿Las menciones en podcasts y YouTube influyen en la visibilidad en IA de una marca?
Las menciones en podcasts y YouTube pueden poner información sobre una marca a disposición de los sistemas de respuesta, pero publicar o detectar una mención no demuestra que haya causado una recomendación.
El mecanismo defendible es informativo. Una fuente plantea una afirmación sobre una marca que queda disponible para una posible recuperación. El relato de un creador sobre el uso de un producto aporta contexto de caso de uso. Una entrevista puede explicar la categoría de una empresa poco conocida a un sistema que no tenía mucho más en qué basarse. Una reseña crítica aporta evidencia en contra de una recomendación. Nada de esto requiere inventar un factor de posicionamiento universal de "mención hablada", y ninguna plataforma documenta algo así.
Mención en la fuente vs. mención en la respuesta vs. recomendación
| Resultado | Qué significa | Qué demuestra sobre los demás |
|---|---|---|
| Mención en la fuente | La marca aparece en un texto fuente recuperable | Nada. El texto fuente y el texto de la respuesta son documentos distintos |
| Mención en la respuesta | La respuesta generada nombra a la marca | Nada sobre un respaldo. Una marca puede nombrarse para describir una limitación, informar sobre una controversia o explicar un hecho histórico |
| Cita | Un enlace de fuente aparece junto a una afirmación generada | Nada sobre orientación de compra. Una fuente puede citarse para una afirmación factual sin respaldar ninguna decisión |
| Recomendación | La respuesta presenta la marca como adecuada para una necesidad concreta | Nada sobre el origen de la información. Una recomendación puede aparecer sin ninguna cita adyacente |
Esta es la distinción central de cómo la IA recomienda marcas, y es la que la mayoría de los informes de campaña borran silenciosamente al contar los cuatro como "visibilidad en IA".
Evidencia recuperada vs. familiaridad aprendida
Una transcripción recién publicada puede aportar evidencia nueva mediante recuperación. Ese es un mecanismo distinto al de un modelo que ha absorbido asociaciones generales sobre una marca durante el entrenamiento, y ambos producen síntomas diferentes. El texto de la respuesta por sí solo no permite distinguir de forma fiable la familiaridad derivada del entrenamiento de la información recuperada. Las citas identifican la atribución mostrada; no revelan la ruta de información completa del sistema.
Mantener esto separado cambia lo que un equipo hace a continuación. Si las respuestas describen mal la marca, hay que identificar las afirmaciones incorrectas e inspeccionar las fuentes mostradas. Si las respuestas omiten la marca, hay que probar las consultas relevantes y la accesibilidad de la fuente antes de decidir qué contenido falta.
Atención vs. evidencia localizable
Una aparición en un podcast importante puede tener un valor comunicativo considerable al margen de su huella de citación. Los oyentes la recuerdan. Los clientes potenciales la mencionan en las llamadas. Los periodistas la usan como contexto. Esos resultados son reales y deben reportarse como tales.
Lo contrario también merece atención. Un episodio con pocas visualizaciones que contiene una explicación inusualmente clara sobre una pregunta técnica concreta es una fuente plausible para esa pregunta. Eso no demuestra que el número de visualizaciones sea irrelevante, ni que los vídeos pequeños reciban trato preferente. Demuestra que relevancia y alcance miden cosas distintas.
El error de análisis es la sustitución. El alcance de audiencia mide exposición. La monitorización de menciones mide referencias detectadas. La observación de citas mide atribución mostrada. El análisis de recomendación evalúa lo que la respuesta realmente aconseja. Cuatro mediciones, cuatro denominadores, sin intercambiabilidad. Y como una sola entrevista puede ramificarse en clips, transcripciones, extractos y resúmenes, ninguno de esos denominadores debería inflarse con URLs derivadas.
¿Una cita de IA demuestra que se usó el podcast?
No, y ahí está el núcleo de la fiabilidad de las citas: una cita solo es tan útil como el respaldo que el material enlazado realmente aporta a la frase junto a la que aparece.
La investigación ALCE sobre cómo permitir que los modelos de lenguaje generen texto con citas, publicada en EMNLP 2023, evalúa la corrección factual y la calidad de la cita como dimensiones separadas. Esa separación importa enormemente en grabaciones largas. Un enlace a una entrevista de noventa minutos puede ser totalmente genuino mientras la afirmación atribuida es infundada, incompleta o se asigna al interlocutor equivocado.
Cita a nivel de episodio frente a respaldo a nivel de pasaje. Una cita a nivel de episodio identifica la grabación. El respaldo a nivel de pasaje identifica la frase que justifica la afirmación. Una marca de tiempo mejora la verificabilidad pero no establece por sí sola la precisión; las palabras en ese momento todavía tienen que respaldar la afirmación, incluidas sus matizaciones. "Un invitado contó que usó el producto con tres agentes" es más acotado que "el producto es ideal para equipos de tres personas", y solo lo primero está en la fuente.
Grabación original frente a relato derivado. Un resumen puede ser una fuente legítima y también puede cambiar palabras, omitir una salvedad o reinterpretar una anécdota. Si un asistente cita el resumen, la atribución es al resumen. El podcast forma parte del historial de la información, no de la ruta de acceso demostrada. Ese historial merece un nombre explícito: linaje de evidencia, la cadena que vincula una declaración original, sus representaciones posteriores y la fuente mostrada en la respuesta. El linaje también explica por qué cinco URL derivadas de una sola entrevista son distribución y no corroboración: multiplican las representaciones detectables sin añadir ni una sola experiencia independiente detrás de la afirmación. El linaje de evidencia es una herramienta analítica, no un factor de posicionamiento.
Repetibilidad frente a corrección. Las respuestas generadas no son deterministas. La misma pregunta planteada dos veces puede producir fuentes distintas, así que una sola cita observada no es prueba de visibilidad estable, ni una sola ausencia es prueba de exclusión. Repetibilidad y corrección también son propiedades separadas: una respuesta puede citar la misma fuente cada vez y tergiversarla cada vez.
Qué ocurre cuando se corrige una afirmación hablada. Esta es la parte más descuidada de la cadena. Si un invitado afirma algo incorrecto y el publicador lo corrige, la corrección tiene que propagarse por el archivo de audio, la transcripción, cualquier transcripción integrada en la app, los resúmenes derivados, las representaciones en caché y todo lo que los motores hayan recuperado previamente. Esos sistemas se actualizan con distinta frecuencia y algunos no se actualizan en absoluto. Una marca que persiga una corrección debe esperar que la versión original siga siendo recuperable en algún sitio durante un tiempo, y debe priorizar que la corrección llegue a la página derivada más citada antes que solo a la grabación original.
Cuenta citas si quieres, pero audita bien al menos tres: ¿el pasaje citado respalda la afirmación exacta?, ¿se acredita al interlocutor correcto?, ¿la respuesta conservó la matización que añadió la fuente?
¿Qué requiere realmente una medición defendible?
Una observación defendible del comportamiento de citación de la IA requiere controlar las variables que cambian el resultado de forma silenciosa. Los hallazgos publicados son más fáciles de interpretar cuando esas variables se revelan.
Las variables que mueven los resultados incluyen la redacción exacta del prompt, el idioma y la región, la personalización y memoria de la cuenta, el modo del producto (con búsqueda activada, investigación profunda, chat estándar), la versión del modelo, si la búsqueda web realmente se activó, el número de ejecuciones repetidas y la fecha de observación. Dos personas pueden ejecutar "la misma prueba" y llegar a conclusiones opuestas sin registrar nada de esto.
El denominador importa tanto como el recuento. Una tasa de citación no significa nada sin un conjunto definido de consultas, un número indicado de ejecuciones por consulta y una regla sobre qué cuenta como citación: una atribución a nivel de afirmación, un enlace relacionado en un panel de fuentes y un enlace de navegación son tres cosas distintas, y la propia documentación de OpenAI señala que un panel de fuentes puede contener fuentes citadas junto con otros enlaces relevantes.
Registro mínimo de observación creíble
| Campo | Por qué importa |
|---|---|
| Prompt, textual | La redacción cambia la recuperación |
| Plataforma y modo | Con búsqueda activada, investigación profunda y chat estándar se comportan de forma distinta |
| Versión del modelo, si se muestra | Las versiones cambian el comportamiento sin previo aviso |
| Fecha y hora | Los resultados son instantáneas |
| Idioma y región | El idioma de la consulta y la ubicación pueden afectar a las fuentes disponibles y a los resultados |
| Si se ejecutó la búsqueda web | Registra si se observó un paso de recuperación web; no establece el origen de cada afirmación |
| Lista completa de fuentes mostradas | Separa las citas a nivel de afirmación de los enlaces relacionados |
| Captura de pantalla o transcripción guardada | Hace que la observación sea auditable más adelante |
| Número de repeticiones | Las respuestas no son deterministas; una sola ejecución es una anécdota |
Si una afirmación sobre visibilidad en IA no cuenta con ese registro, es una impresión. Trata las observaciones aisladas como evidencia preliminar y expón sus limitaciones al tomar decisiones de presupuesto.
Esta es también la razón por la que el seguimiento de citas de IA debería diseñarse como una serie longitudinal y no como una búsqueda puntual de capturas de pantalla. La pregunta no es "¿aparecimos hoy?", sino "¿con qué frecuencia, para qué preguntas, con qué descripción, durante qué período?".
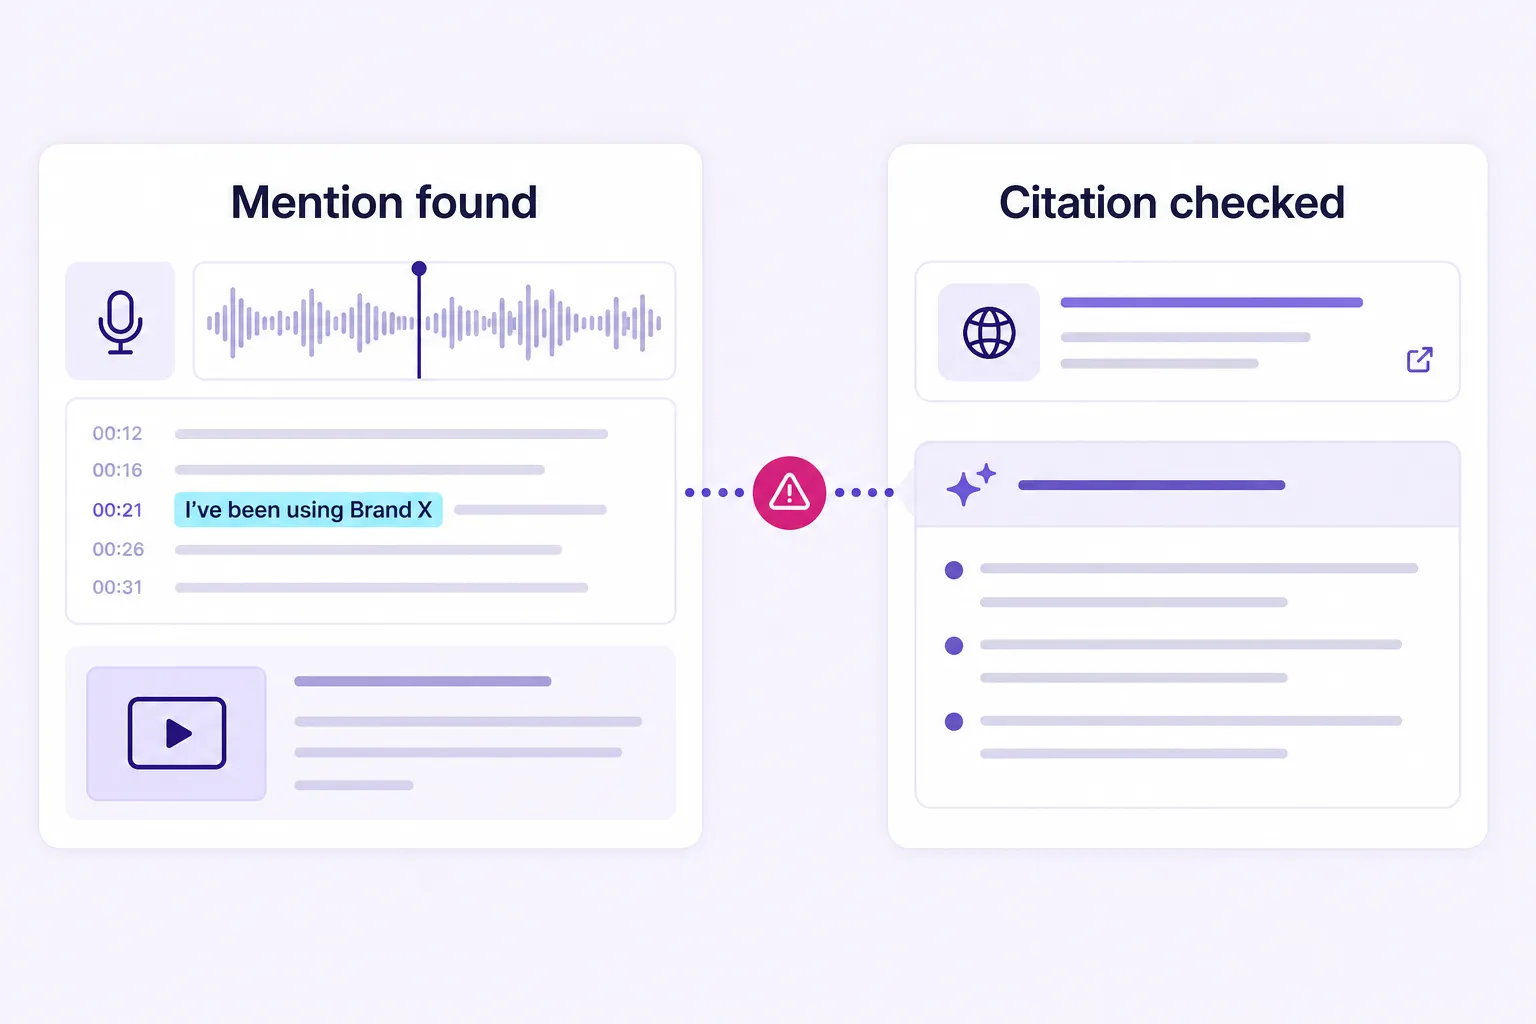
Cómo monitorizar menciones de marca habladas en podcasts y vídeos
La monitorización de menciones habladas y la monitorización de respuestas de IA observan dos partes distintas del mapa de evidencia, y confundirlas produce tanto optimismo infundado como pesimismo infundado.
Un sistema que busca solo en títulos, descripciones, publicaciones y comentarios no puede identificar una referencia de marca que existe únicamente en el habla. Una marca puede ser el tema central de una conversación de cuarenta y cinco minutos, nombrada una docena de veces, y registrar cero coincidencias en un panel basado solo en texto porque el episodio se llama "Tendencias del sector T3". La monitorización con reconocimiento de transcripciones amplía el material rastreable para incluir el habla representada.
Ese es el papel específico que ocupa BrandMentions en este punto: detección de menciones habladas basada en transcripciones, integrada dentro de una monitorización más amplia de la web pública y las redes sociales. Su cobertura documentada de YouTube incluye títulos de vídeo, descripciones y comentarios, y su funcionalidad de Menciones Habladas busca en transcripciones de vídeos y podcasts nombres de marca dichos en voz alta, incluidas referencias que nunca aparecen en el texto descriptivo circundante cuando una transcripción accesible las contiene. Estos hallazgos pueden leerse junto con la monitorización de medios en redes sociales, noticias, blogs, foros, plataformas de reseñas y sitios web, lo que es precisamente lo que hace que una referencia hablada sea interpretable en lugar de aislada.
Hay que dejar claros dos límites, porque exagerar en este punto es endémico en esta categoría. Los datos oficiales del producto describen la detección basada en transcripciones y las fuentes cubiertas. No establecen una transcripción independiente de cada fuente de audio existente, ni una cobertura completa de cada grabación pública, ni ninguna afirmación comparativa sobre precisión, exhaustividad o latencia de detección. La documentación del producto citada no proporciona un benchmark reproducible de forma independiente para la precisión, la exhaustividad o la latencia de detección. Y la detección es una capacidad de monitorización, no un mecanismo de envío: encontrar una mención hablada no hace que esa mención sea visible para, recuperada por, o citada por ningún motor de búsqueda de IA.
Detección de menciones frente a observación de citas
Una mención hablada detectada establece que un sistema de monitorización encontró una referencia en su material disponible. No establece que ChatGPT, Perplexity, Gemini o Google hayan recuperado alguna vez ese material.
Lo contrario también es cierto. Una respuesta de IA podría citar la página de un episodio que contiene solo notas del programa, lo que demuestra una cita de fuente sin demostrar que se haya procesado ninguna referencia hablada.
Dos conjuntos de evidencia, que deben mantenerse separados:
Evidencia de la conversación: dónde se habló de la marca, qué se dijo, quién lo dijo y en qué contexto.
Evidencia de la respuesta: qué respuesta del asistente nombró la marca, qué afirmación hizo y qué fuente mostró.
El vínculo entre ambas debe observarse, no asumirse.
Juzga un programa de monitorización por cuántas menciones tienes que leer, no por cuántas recopila. El resultado útil es ese puñado que cambia una decisión: una queja que se está formando, un competidor que reclama tu categoría, una transcripción que cita mal tu producto.
Por qué esta distinción importa para RR. PP., reputación e inteligencia de marca
Para relaciones públicas, una mención exclusiva de transcripción saca a la luz cobertura ganada que un informe basado en título y descripción no puede ver por su propia estructura. Para los equipos de reputación, expone una queja, una comparación o una afirmación inexacta que merece una respuesta, la repita o no algún asistente. Para la inteligencia de marca, muestra el lenguaje espontáneo que la gente usa sobre el producto, que suele ser mejor insumo para el mensaje de marca que cualquier encuesta. Para el trabajo de visibilidad en IA, identifica fuentes candidatas que vale la pena examinar, y "candidata" es la palabra clave: la fuente se ha vuelto visible para el analista, no necesariamente para ningún motor de respuestas.
La regla de decisión es breve. Si una mención hablada detectada tiene una representación textual accesible, registra su URL e inclúyela en las comprobaciones de citas que ya realizas. Si no la tiene, has encontrado atención ganada que la recuperación basada en texto no puede ver actualmente, y la decisión es si pedir al editor una transcripción o mejores notas del programa, buscar cobertura que puedas ganar legítimamente, o simplemente valorarla como un resultado de audiencia y reportarla como tal.
Preguntas frecuentes
¿Puede ChatGPT citar vídeos de YouTube?
Sí, con condiciones: un enlace de YouTube puede aparecer como referencia en una respuesta de ChatGPT, pero lo que se cita es la página, no el audio. La documentación de búsqueda de OpenAI no establece un acceso universal a las transcripciones de vídeo ni un análisis directo del audio, y señala que las citas pueden ser inexactas y que un panel de fuentes puede incluir enlaces que no se citaron para ninguna afirmación concreta. Una cita de una página web sobre un vídeo también es algo distinto de una afirmación respaldada por el contenido hablado del vídeo, así que la evidencia subyacente hay que comprobarla, no inferirla del enlace.
¿Citan los AI Overviews de Google los vídeos de YouTube?
Sí, con condiciones: una página de reproducción de YouTube puede aparecer como enlace de apoyo cuando está indexada y es apta para aparecer en Google Search con un fragmento (snippet), que es la condición documentada por Google para los AI Overviews y el AI Mode, sin requisitos técnicos adicionales. Esa elegibilidad es una condición previa, no una garantía de inclusión. Y un enlace de YouTube mostrado no revela si los subtítulos, la descripción, una integración de plataforma o una página de terceros aportaron la evidencia detrás de la frase a la que acompaña.
¿Usa Perplexity las transcripciones de YouTube?
La documentación citada aquí no establece si Perplexity recupera transcripciones de YouTube, ni con qué grado de exhaustividad. Publica un caso de uso de descubrimiento de vídeo en el que el producto localiza un vídeo relevante y, en contextos como su navegador, abre un segmento específico, y su documentación de rastreadores separa PerplexityBot (localizar y enlazar sitios web en los resultados de búsqueda) de Perplexity-User (visitar una página en respuesta a una solicitud del usuario). Son capacidades con condiciones, no un compromiso documentado de indexar cada referencia hablada en YouTube ni de ponderar las transcripciones igual que las páginas web editoriales.
¿Indexan los motores de búsqueda de IA las transcripciones de YouTube?
No como regla general: ninguna plataforma documenta una garantía multiplataforma de que cada transcripción de YouTube quede indexada por cada motor de búsqueda de IA. La existencia de la transcripción, el acceso específico del sistema y la recuperación específica de la consulta son tres condiciones distintas. El requisito publicado por Google para los enlaces de apoyo en los AI Overviews y el AI Mode se refiere a páginas indexadas y aptas para aparecer con un fragmento, lo cual no es un compromiso de indexar cada frase hablada en la plataforma.
¿Qué motor de búsqueda de IA cita más YouTube?
Depende del estudio. En el análisis de BrightEdge, los motores de IA de Google fueron los que más citaron YouTube y ChatGPT, el que menos, con Perplexity en un punto intermedio.
En el análisis de BrightEdge, YouTube obtuvo una cuota de citas del 29,5% en Google AI Overviews (dominio nº 1, posición media 6,3), del 16,6% en Google AI Mode (dominio nº 1, posición media 9,7), del 9,7% en Perplexity (dominio nº 5) y del 0,2% en ChatGPT (posición media 5,2), medido en esos cuatro productos entre mayo de 2024 y septiembre de 2025 usando su plataforma AI Catalyst. Otros conjuntos de datos -Profound, el estudio de 30 millones de fuentes de Peec AI y el estudio de fuentes 2026 de Agenzy- reportan magnitudes distintas sobre conjuntos de prompts diferentes.
¿Cómo consigo que mi pódcast sea citado por ChatGPT o Google AI Mode?
Primero haz que la página del episodio sea citable, y luego mide. Recorre los pasos 1 a 4 de la lista de verificación de citabilidad: publica una transcripción HTML precisa en la página del episodio, nombra el producto, la categoría y el caso de uso en la capa escrita, confirma que la página está indexada y es apta para fragmentos, y audita por separado cada directiva de rastreador, índice y fragmento, porque OAI-SearchBot y GPTBot tienen controles de robots.txt independientes para la búsqueda y el posible uso en entrenamiento. ChatGPT-User gestiona ciertas visitas iniciadas por el usuario, para las que las reglas de robots.txt pueden no aplicarse.
¿Ayudan las transcripciones de pódcast a la visibilidad en IA?
Sí, con condiciones: una transcripción HTML publicada en la página del episodio es la representación con más probabilidades de ser alcanzable mediante el descubrimiento web ordinario, porque convierte el habla en texto en una dirección rastreable con los interlocutores identificados, que es también lo que describe la guía de accesibilidad del W3C. Aporta una representación textual y puede reducir los obstáculos de acceso, siempre que la página sea alcanzable por el sistema correspondiente. Las transcripciones dentro de un panel de creador, un archivo de feed o una app de escucha contienen las mismas palabras en una situación de acceso distinta, así que "el episodio tiene transcripción" no es, por sí solo, una afirmación de visibilidad.
¿Pueden los motores de búsqueda de IA citar pódcasts sin una transcripción completa?
Sí. Una página de episodio, unas notas de programa detalladas o un relato publicado por terceros pueden aportar evidencia recuperable sin que exista ninguna transcripción. La limitación está en lo que esa fuente realmente contiene: una descripción que nunca nombra la marca no puede respaldar una referencia hablada por el simple hecho de enlazar al episodio.
¿Cómo compruebo si un motor de IA citó mi pódcast?
Ejecuta de forma repetida un conjunto fijo de preguntas con estilo de comprador en cada plataforma y modo, y registra el prompt, la plataforma, el modo, la versión del modelo si está visible, la fecha y hora, la configuración regional, si se ejecutó búsqueda web, la lista completa de fuentes mostradas, una captura de pantalla y el número de repeticiones. Luego audita las citas en lugar de contarlas: confirma que el pasaje citado respalda la afirmación exacta, que se acredita al interlocutor correcto y que la respuesta conservó la matización que añadió la fuente. Dado que las respuestas no son deterministas, una sola cita observada no prueba visibilidad estable y una sola ausencia no prueba exclusión; por eso debe ser una serie fechada y no una única captura.
¿Cuenta una mención de marca hablada como una recomendación de la IA?
No. Una mención hablada es un suceso dentro del material fuente. Una recomendación de la IA es una propiedad de una respuesta generada que presenta una marca como apta para una necesidad concreta. Una respuesta puede citar una fuente que nombra una marca, nombrar la marca por un motivo neutral o crítico, y recomendar otra cosa completamente distinta, todo en la misma respuesta.
Conclusión: la estructura perdura más que las funciones
Una marca puede estar en el centro de una conversación importante sin aparecer jamás en una sola descripción escrita de ella. Esa conversación merece atención antes de convertirse en una cita de IA, y tanto si eso llega a ocurrir como si no. Saber que sucedió es el activo medible disponible hoy. Que la citen por ello sigue siendo una posibilidad, nunca una promesa, y quien la venda como lo segundo está describiendo una esperanza, no un mecanismo.
Filed under: Visibilidad en IA y SEO